Até pouco tempo atrás, executar modelos avançados de linguagem (LLMs) localmente no computador parecia um privilégio reservado a engenheiros de machine learning com máquinas supercaras. O processo tradicional costumava envolver a instalação de ambientes virtuais em Python, dezenas de bibliotecas em conflito, drivers pesados de aceleração e servidores de inferência complexos.
No entanto, a divisão de inteligência artificial da criadora do Firefox concebeu uma solução tão simples que parece mágica: o Llamafile. Trata-se de um projeto de código aberto mantido pela Mozilla que empacota toda a infraestrutura necessária para rodar inteligência artificial dentro de um único arquivo executável portátil, capaz de rodar com apenas dois cliques no Linux, Windows ou macOS.
A analogia do restaurante e a mágica do Cosmopolitan Libc
Para entender o salto de engenharia do Llamafile, podemos recorrer a uma analogia clássica do mundo real.
No método tradicional de deploy de IA, o usuário precisa montar uma “cozinha completa”: você define o imóvel (o sistema operacional), compra os utensílios e fogões (as bibliotecas de hardware e compiladores), contrata o cozinheiro (o motor de inferência) e adquire os ingredientes (os pesos matemáticos do modelo). Se você resolver mudar de sistema operacional, precisa reconstruir a cozinha inteira.
O Llamafile funciona como um Food Truck de alta eficiência: ele junta o motor, as ferramentas e os ingredientes dentro da mesma caixa autossuficiente. Para alcançar essa façanha multiplataforma, o projeto combina dois pilares tecnológicos fundamentais:
- llama.cpp: O consagrado motor de inferência ultraotimizado em C e C++ desenvolvido por Georgi Gerganov e mantido no repositório do llama.cpp no GitHub.
- Cosmopolitan Libc: Criada pela engenheira Justine Tunney na iniciativa Cosmopolitan Libc, essa biblioteca C especializada permite compilar um código binário universal em formato ELF/PE/Mach-O que roda nativamente sobre qualquer sistema operacional sem necessidade de instalação prévia.
Baixando e executando: o mmap() em ação
Para começar a usar, basta acessar o repositório oficial da Mozilla no GitHub ou a página de modelos pré-compilados do projeto e fazer o download do arquivo correspondente ao modelo desejado (como variantes do Llama, Mistral ou Qwen).
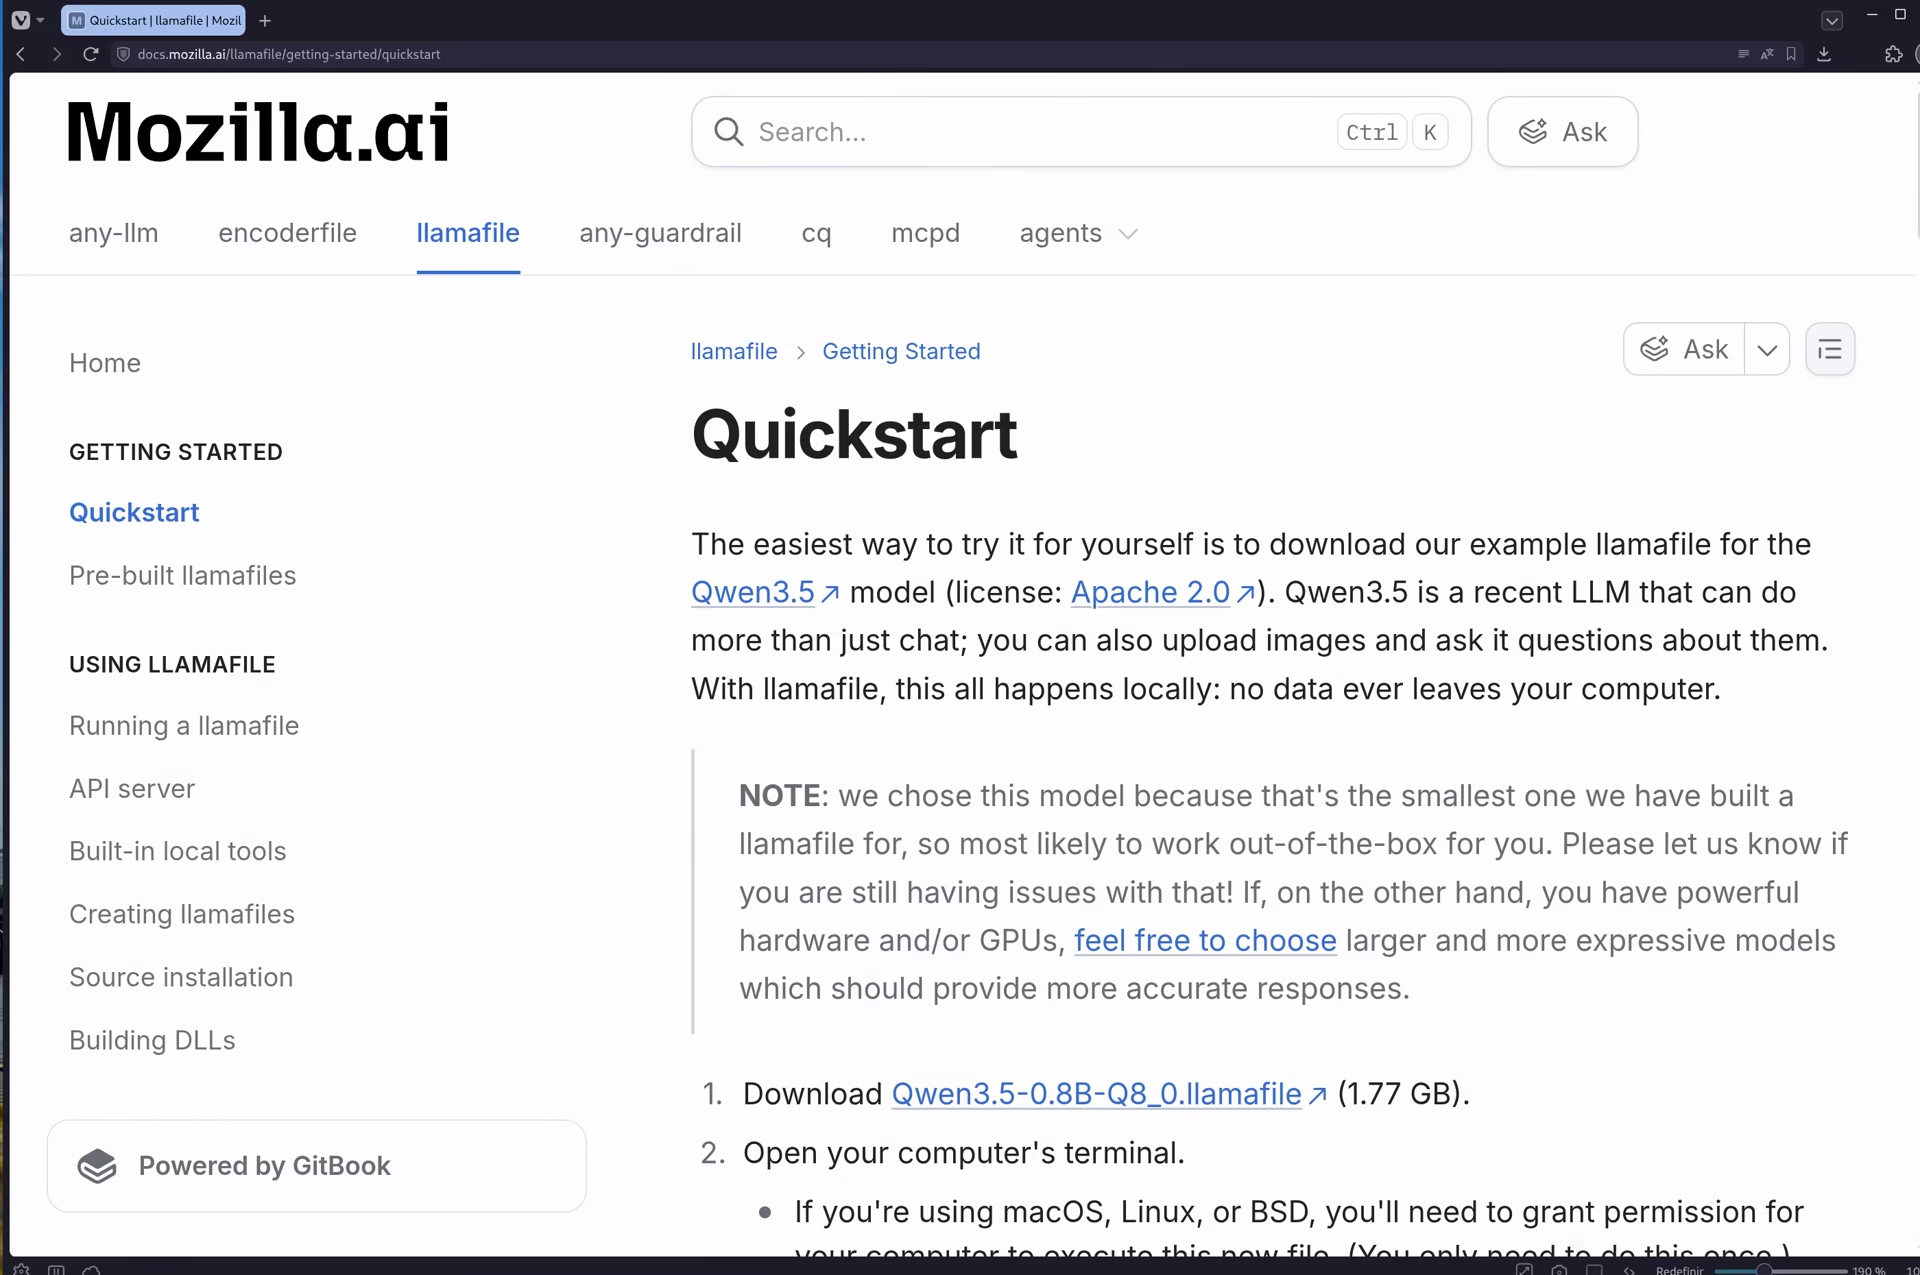
No Linux, basta conceder permissão de execução ao arquivo (chmod +x arquivo.llamafile) e executá-lo diretamente pelo terminal ou com um duplo clique no gerenciador de arquivos. Instantaneamente, o Llamafile inicializa um servidor web local e abre uma interface de chat no seu navegador padrão.
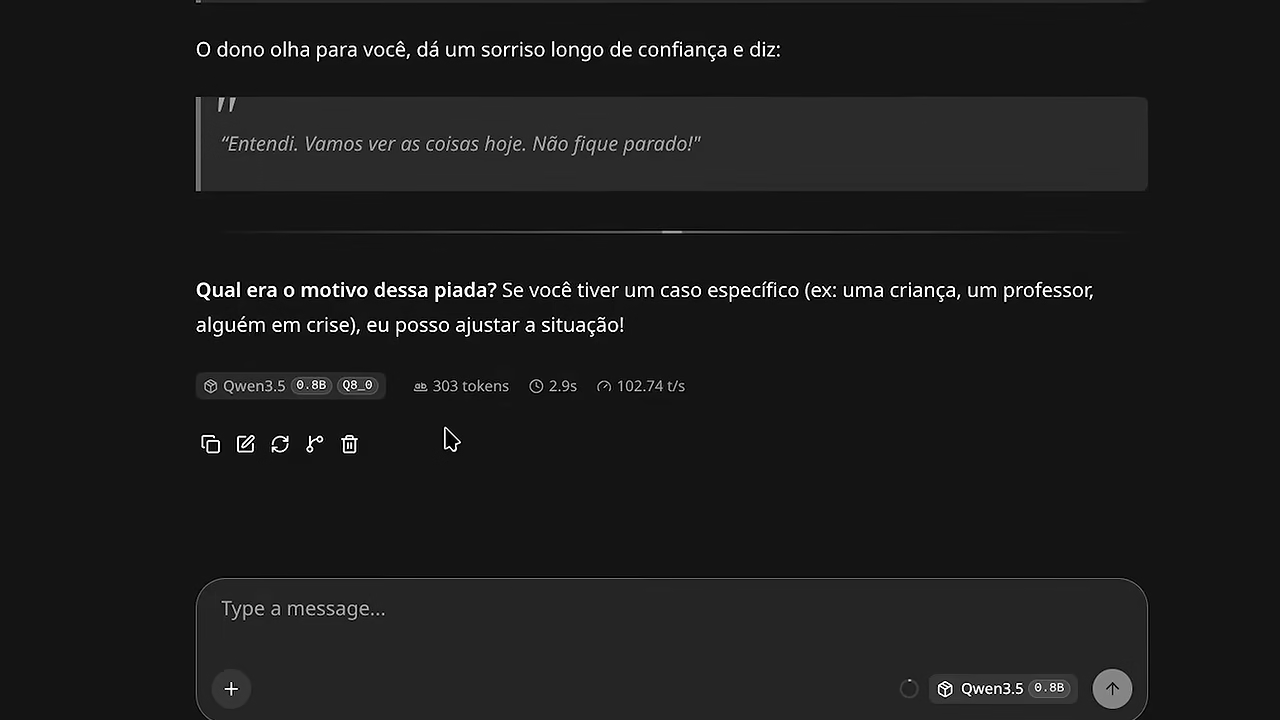
Mas como um arquivo de vários gigabytes consegue abrir quase que instantaneamente sem travar o computador descompactando dados?
A resposta está na chamada de sistema mmap() (Memory-Mapped File). Em vez de ler e copiar gigabytes de dados do disco para a memória RAM de forma lenta e sequencial, o sistema operacional mapeia os ponteiros do arquivo diretamente no espaço de endereçamento virtual da memória. Dessa forma, a CPU ou a GPU passam a ler os pesos do modelo diretamente do armazenamento em milissegundos, sem desperdício de memória física.
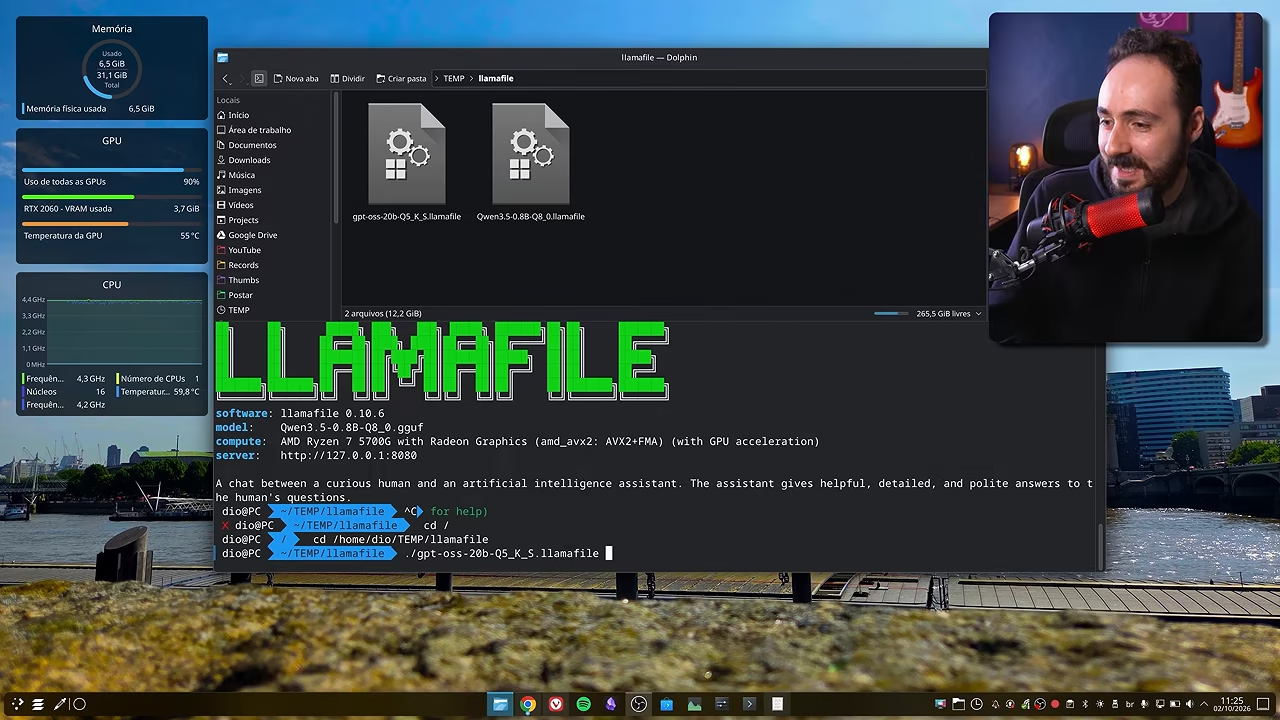
Crie o seu próprio Llamafile customizado
Além de usar as compilações prontas, você pode transformar qualquer modelo no formato padrão GGUF (baixado de plataformas como o Hugging Face) em seu próprio executável portátil.
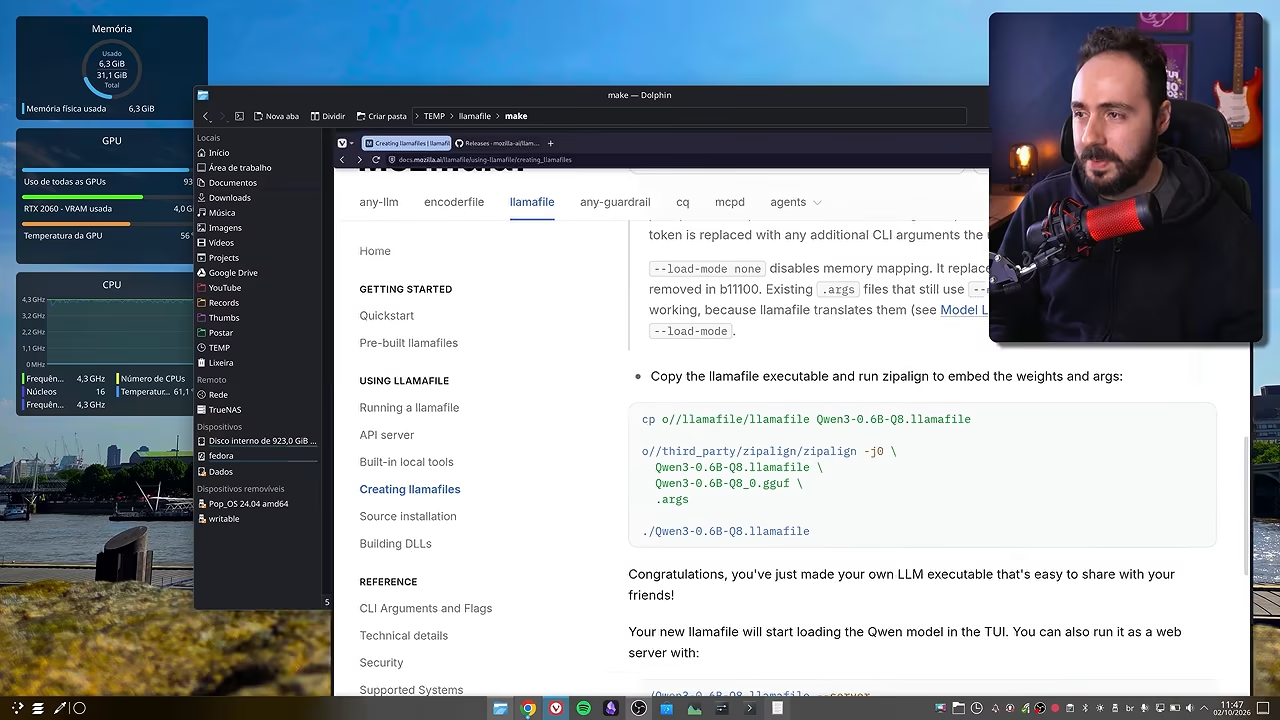
O processo é surpreendentemente engenhoso: como o executável do Llamafile utiliza a estrutura interna do formato ZIP, basta criar um arquivo de texto .args com os parâmetros de contexto desejados e utilizar a ferramenta zipalign para embutir os pesos e as instruções diretamente no binário universal.
Essa capacidade abre portas para casos de uso revolucionários:
- Privacidade absoluta para profissionais: Médicos, advogados e contadores podem analisar relatórios confidenciais em computadores desconectados da internet sem que uma única linha de texto seja enviada para servidores de terceiros.
- Ambientes remotos e industriais: IAs embarcadas que operam em navios, fábricas, laboratórios de campo ou escolas sem conexão estável de rede.
- Portabilidade em pendrive: Carregar uma inteligência artificial completa no bolso e executá-la em qualquer máquina da faculdade ou do trabalho.
Além do texto: Whisperfile e Diffusionfile
O ecossistema mantido pela Mozilla não se limita a conversas por texto. A iniciativa expandiu a tecnologia para outras modalidades criativas:
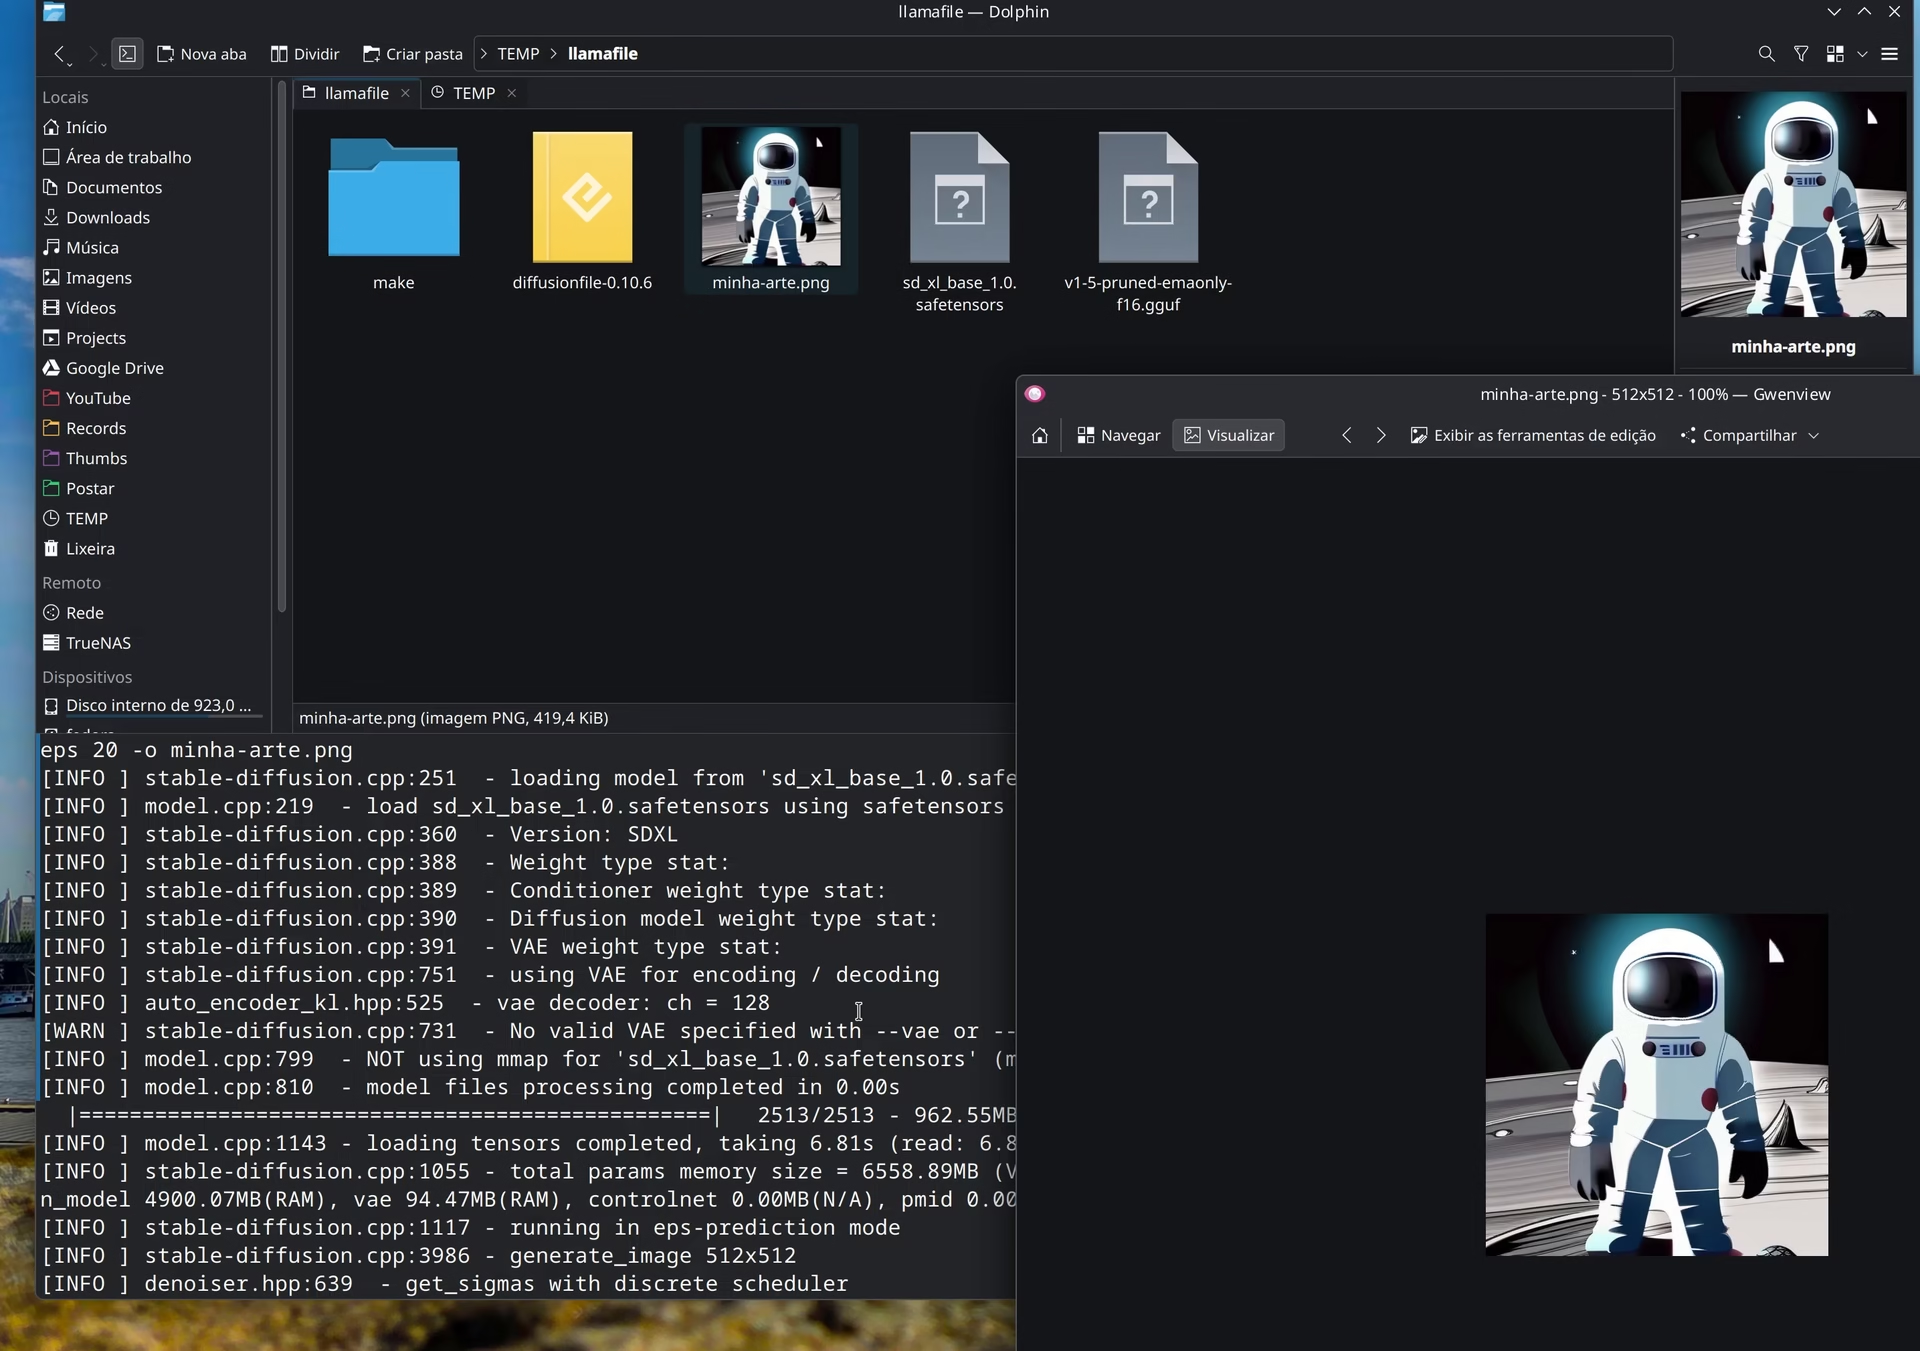
- Whisperfile: Converte gravações de voz em texto com precisão impressionante utilizando o modelo Whisper da OpenAI de forma totalmente offline, alinhado à proposta de privacidade que destacamos ao cobrir o projeto Myna no Ubuntu.
- Diffusionfile: Utiliza pesos de modelos Stable Diffusion para gerar ilustrações e arte visual diretamente pela linha de comando.
Enquanto grandes empresas continuam investindo em modelos de IA centralizados na nuvem, o Llamafile prova que a verdadeira democratização da tecnologia passa pelo empoderamento do usuário com ferramentas locais, abertas e soberanas.
Se você quer dominar o ecossistema Linux e ter acesso a cursos completos, tutoriais aprofundados e conteúdos exclusivos, seja membro do Diolinux! No Diolinux Play você expande seus conhecimentos e apoia diretamente a produção de conteúdo independente.